Inteligencia artificial para ensayos clínicos, dentro del EDC
Datacapt AI construye el estudio, revisa los datos según llegan y vigila tus centros. Funciona con tus permisos, escribe en tu pista de auditoría y se detiene en el límite que tú fijas. Conecta tu propio modelo por MCP, o usa el nuestro.
Usa nuestro agente, o conecta tu propio modelo
Datacapt expone su EDC a través de un servidor Model Context Protocol. Usa el asistente que viene con la plataforma, o apunta Claude, ChatGPT, Gemini, Grok o un modelo que alojes tú mismo al mismo servidor. Mismos permisos, misma pista de auditoría.
Datacapt AI, dentro de la plataforma
Pregunta en el chat que está junto a tus estudios. Nada que instalar, ninguna clave que gestionar, ninguna cuenta de proveedor que abrir.
Tu modelo, por MCP
Trae el cliente y el modelo que tu organización ya aprobó. El protocolo es un estándar abierto: nada te ata a nuestra elección de proveedor.
Tres momentos de un estudio donde se va el tiempo de verdad
Lectura del protocolo, diseño del eCRF, revisión de datos, monitorización, auditorías, ejecución multilingüe. Un estudio pierde tiempo en cada uno. Estos son los tres donde un agente devuelve más.
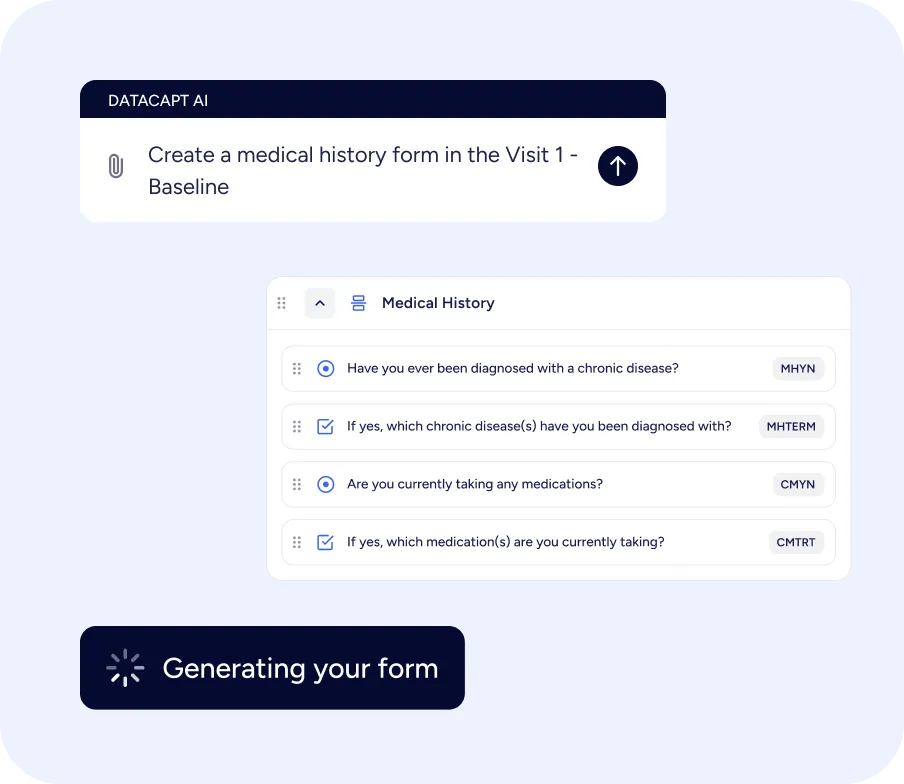
Construye el estudio desde el calendario de evaluaciones
Pasar de un protocolo a un eCRF operativo lleva semanas. Pensarlo es rápido. Lo que come el tiempo es la introducción: visitas, formularios, campos, controles de coherencia, condiciones de visibilidad y después los guiones de prueba.
Revisa lo que cambió, no cada campo otra vez
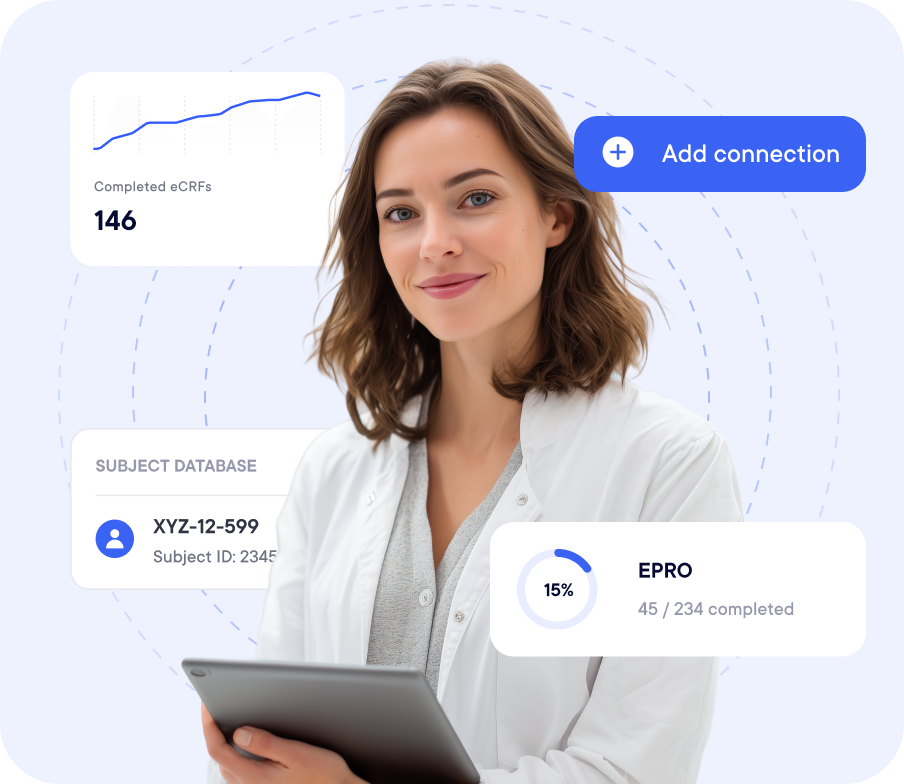
La revisión manual no sigue el ritmo de un ensayo moderno. Datacapt AI lee los datos según llegan y pone arriba de la cola lo que merece tu atención.
Envía a tus monitores a los centros que los necesitan
Datacapt AI lee las señales de centro y de estudio según se mueven, de modo que la monitorización basada en riesgo sigue lo que dicen los datos esta semana en lugar del plan escrito el trimestre pasado.
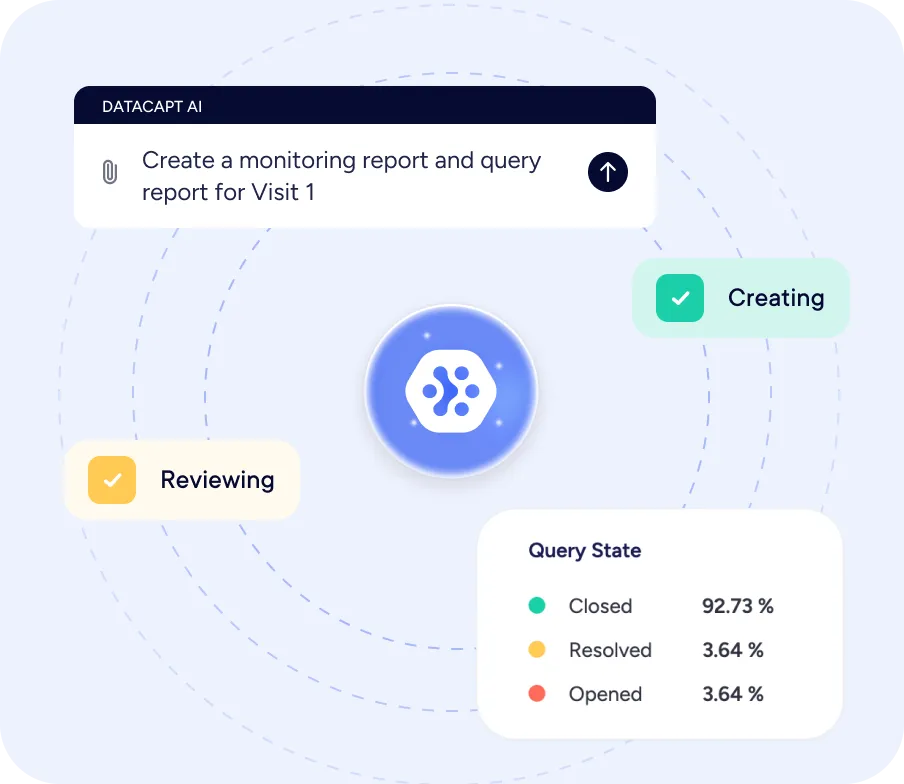
Di lo que necesitas. El agente hace la entrada.
Un servidor MCP publica las capacidades del EDC como herramientas que un agente puede descubrir y llamar. Tu data manager formula la petición en lenguaje claro, el agente elige las herramientas e informa de lo que escribió, y una persona valida antes de que nada llegue a producción.
Seis peticiones, ninguna integración que desarrollar
Cada una cabe en una frase en una ventana de chat. Detrás, el agente elige entre las herramientas que expone el servidor MCP, las llama en orden e informa de lo que hizo. Añadir una séptima petición te cuesta una frase, no un ciclo de desarrollo.
El modelo nunca ve tus datos clínicos
Enviar datos de salud a un modelo público es un riesgo que la mayoría de promotores y CRO no asume. Podríamos hacerlo con contratos, cifrado y alojamiento certificado. En su lugar no enviamos nada, y todo lo demás se deriva de esa única decisión.
Las escrituras caen en DRAFT
El agente escribe en un estudio borrador o en una versión nueva. Editar un formulario publicado, aplicar un código o tocar datos recogidos no está expuesto en absoluto. El control está en el backend.
Una clave por usuario
La clave MCP es distinta de la clave API: individual, limitada en el tiempo, revocable en un clic, con scopes y cuotas fijados en la creación. Ninguna clave de organización, ninguna cuenta de servicio.
Origen MCP en la pista de auditoría
Cada llamada se registra con su herramienta, sus parámetros, la marca de tiempo y la persona que la pidió. Un auditor aísla el conjunto con un solo filtro. El actor registrado es siempre una persona.
Una persona acepta la producción
El agente prepara. Tu data manager revisa la configuración, corrige lo que haga falta, valida las pruebas y firma el paso a LIVE con su propio nombre.
Datacapt AI es un conjunto de capacidades de inteligencia artificial integradas de forma nativa en la plataforma eClinical de Datacapt. Soporta actividades clave de los ensayos clínicos como el diseño de estudios, la revisión de datos, la monitorización, la gestión de queries, la revisión del audit trail y la traducción. Datacapt AI asiste a los usuarios identificando patrones, sugiriendo acciones y mejorando la eficiencia, manteniendo siempre el control humano total y la trazabilidad regulatoria.
Sí. Datacapt AI opera dentro del entorno validado de Datacapt y sigue principios estrictos de trazabilidad, transparencia y control por parte del usuario. Todas las acciones se registran, son auditables y están alineadas con los marcos de cumplimiento de la investigación clínica. Los resultados de la IA son explicables y pueden revisarse en cualquier momento.
No. Datacapt AI está diseñado para apoyar a los equipos clínicos, no para reemplazarlos. Todas las sugerencias, queries e insights generados por la IA requieren revisión y validación humana. La toma de decisiones, las aprobaciones y la responsabilidad recaen siempre en profesionales clínicos cualificados, de acuerdo con las expectativas regulatorias.
Sí. Datacapt AI es compatible con estudios internacionales al permitir la traducción instantánea de eCRFs, ePROs, queries y contenido de estudios. Esto contribuye a garantizar una terminología coherente, reducir errores de traducción y acelerar la implementación multilingüe.
Datacapt AI asiste en el diseño de eCRFs sugiriendo estructuras de formularios, campos, edit checks y validaciones basados en el contenido del protocolo y el contexto terapéutico. Esto permite reducir significativamente el tiempo de configuración.
No. Datacapt AI no genera ni altera datos clínicos. Analiza los datos y flujos de trabajo existentes para proporcionar sugerencias, alertas e insights. Toda la entrada de datos, las modificaciones y las aprobaciones permanecen bajo el control humano total y quedan registradas en el audit trail, de acuerdo con las regulaciones clínicas.
Datacapt AI está diseñado específicamente para ensayos clínicos e integrado directamente en la plataforma eClinical de Datacapt. A diferencia de las herramientas de IA genéricas, está construido en torno a los flujos de trabajo clínicos, las restricciones regulatorias y los requisitos de integridad de datos, garantizando que la IA aporte valor operativo sin comprometer el cumplimiento ni el control.
El Model Context Protocol es un estándar abierto que describe cómo un gran modelo de lenguaje descubre y llama a las funciones de una aplicación de terceros. El servidor MCP de Datacapt publica las capacidades del EDC como herramientas que un agente puede llamar: un data manager formula su petición en lenguaje claro en lugar de esperar a que se desarrolle un conector para ella. La API REST sigue haciendo el trabajo por debajo. MCP añade la capa que permite a un modelo usarla sin que un desarrollador escriba una integración para cada escenario.
Sí. Puedes gobernar Datacapt desde el chat integrado en la plataforma, o desde el cliente MCP que elijas conectado al modelo que tu organización haya aprobado: Claude, ChatGPT, Gemini, Grok o un modelo que alojes localmente. El protocolo no depende del modelo. Ambas rutas pasan por el mismo servidor MCP, con los mismos scopes y la misma pista de auditoría: un modelo local no obtiene más acceso que el integrado.
No. El modelo recibe volúmenes, estados, porcentajes y estructuras: el reclutamiento por centro, la tasa de SDV, el desglose de queries por antigüedad, las secciones de un formulario con sus reglas de validación. Nunca recibe un valor introducido en un eCRF, una respuesta ePRO, un identificador de sujeto o de screening, el contenido de un consentimiento ni un elemento de aleatorización. Los endpoints de monitorización que devuelven filas a nivel de reclutamiento se agregan primero en el servidor: una fila en bruto nunca sale de la plataforma. La única excepción es un término verbatim enviado solo para una sugerencia de codificación, sin sujeto, centro, fecha ni visita.
No. Las escrituras se limitan a estudios en DRAFT o a una nueva versión del estudio, y ese control está en el backend y no en las instrucciones dadas al modelo. Editar un formulario publicado, aplicar un código o escribir sobre datos recogidos no está expuesto como herramienta. Pasar a producción exige la aceptación explícita de un usuario, registrada en la pista de auditoría a su nombre. Una vez el estudio está en LIVE, cualquier cambio pasa por una nueva versión, que vuelve a borrador, y el agente con ella.
Blog y noticias
Noticias, artículos, recursos y tutoriales.