L'intelligence artificielle pour les essais cliniques, dans l'EDC
Datacapt AI construit l'étude, revoit les données à mesure qu'elles arrivent et surveille vos centres. Il tourne sur vos permissions, écrit dans votre piste d'audit et s'arrête à la limite que vous fixez. Branchez votre propre modèle via MCP, ou utilisez le nôtre.
Utilisez notre agent, ou connectez votre propre modèle
Datacapt expose son EDC via un serveur Model Context Protocol. Utilisez l'assistant livré avec la plateforme, ou pointez Claude, ChatGPT, Gemini, Grok ou un modèle que vous hébergez vous-même vers le même serveur. Mêmes permissions, même piste d'audit.
Datacapt AI, dans la plateforme
Demandez dans le chat qui se tient à côté de vos études. Rien à installer, aucune clé à gérer, aucun compte fournisseur à ouvrir.
Votre modèle, via MCP
Amenez le client et le modèle que votre organisation a déjà validés. Le protocole est un standard ouvert : rien ne vous lie à notre choix de fournisseur.
Trois moments d'une étude où le temps part vraiment
Lecture du protocole, conception de l'eCRF, revue des données, monitoring, audits, exécution multilingue. Une étude perd du temps sur chacun d'eux. Voici les trois où un agent en rend le plus.
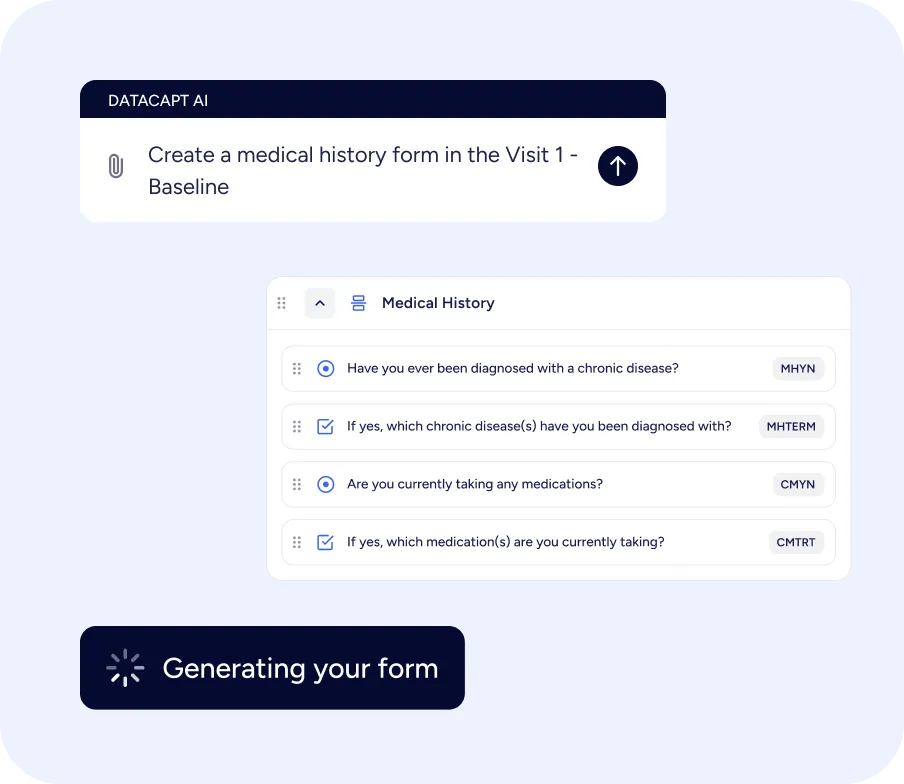
Construisez l'étude à partir du calendrier des évaluations
Passer d'un protocole à un eCRF opérationnel prend des semaines. La réflexion va vite. Ce qui mange le temps, c'est la saisie : visites, formulaires, champs, contrôles de cohérence, conditions d'affichage, puis les scripts de test.
Revoyez ce qui a changé, pas chaque champ à nouveau
La revue manuelle ne suit pas le rythme d'un essai moderne. Datacapt AI lit les données à mesure qu'elles arrivent et place en haut de la file ce qui mérite votre attention.
Envoyez vos ARC là où on a besoin d'eux
Datacapt AI lit les signaux au niveau centre et au niveau étude à mesure qu'ils bougent, si bien que le monitoring basé sur le risque suit ce que disent les données cette semaine plutôt que le plan écrit au trimestre dernier.
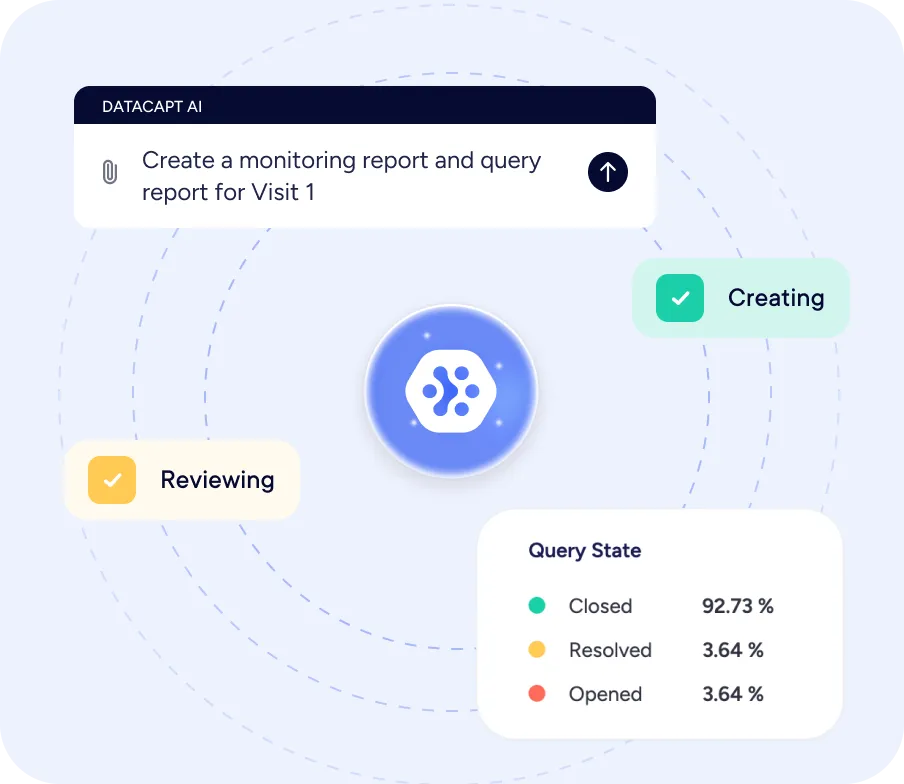
Dites ce dont vous avez besoin. L'agent fait la saisie.
Un serveur MCP publie les capacités de l'EDC comme des outils qu'un agent peut découvrir et appeler. Votre data manager formule la demande en langage clair, l'agent choisit les outils et rend compte de ce qu'il a écrit, et une personne valide avant que quoi que ce soit atteigne la production.
Six demandes, aucune intégration à développer
Chacune tient en une phrase dans une fenêtre de chat. Derrière, l'agent choisit parmi les outils que le serveur MCP expose, les appelle dans l'ordre et rend compte de ce qu'il a fait. Ajouter une septième demande vous coûte une phrase, pas un cycle de développement.
Le modèle ne voit jamais vos données cliniques
Envoyer des données de santé à un modèle public est un risque que la plupart des promoteurs et des CRO refusent. Nous pourrions le faire avec des contrats, du chiffrement et un hébergement certifié. Nous n'en envoyons rien du tout, et tout le reste découle de cette seule décision.
Les écritures atterrissent en DRAFT
L'agent écrit dans une étude brouillon ou dans une nouvelle version. Modifier un formulaire publié, appliquer un code ou toucher aux données collectées n'est pas exposé du tout. Le contrôle est dans le backend.
Une clé par utilisateur
La clé MCP est distincte de la clé API : individuelle, limitée dans le temps, révocable en un clic, avec des scopes et des quotas fixés à la création. Aucune clé d'organisation, aucun compte de service.
Origine MCP dans la piste d'audit
Chaque appel est journalisé avec son outil, ses paramètres, l'horodatage et la personne qui a demandé. Un auditeur isole l'ensemble avec un seul filtre. L'acteur enregistré est toujours une personne.
Une personne valide la production
L'agent prépare. Votre data manager relit la configuration, corrige ce qui doit l'être, valide les tests et signe le passage en LIVE sous son propre nom.
Datacapt AI est un ensemble de fonctionnalités d'intelligence artificielle nativement intégrées à la plateforme eClinical de Datacapt. Elle soutient les activités clés de l’essai : conception de l'étude, revue des données, monitoring, gestion des requêtes (queries), revue de l’audit trail et traduction. Datacapt AI assiste les utilisateurs en identifiant des schémas, en suggérant des actions et en améliorant l’efficacité opérationnelle, tout en garantissant un contrôle humain total et une traçabilité réglementaire complète.
Oui. Datacapt AI opère au sein de l'environnement validé de Datacapt et suit des principes stricts de traçabilité, de transparence et de contrôle utilisateur. Toutes les actions sont enregistrées, auditables et alignées sur les cadres de conformité de la recherche clinique. Les résultats générés par l'IA sont explicables et peuvent être vérifiés à tout moment.
Non. Datacapt AI est conçu pour soutenir les équipes cliniques, et non pour les remplacer. Toutes les suggestions, requêtes ou analyses générées par l'IA nécessitent une revue et une validation humaine. La prise de décision, les approbations et la responsabilité finale incombent toujours aux professionnels de la recherche clinique, conformément aux exigences réglementaires.
Oui. Datacapt AI soutient les études internationales en permettant la traduction instantanée des eCRF, ePRO, requêtes et contenus d'étude. Cela garantit une terminologie cohérente, une communication plus rapide avec les sites et une exécution plus fluide à travers plusieurs pays et langues, tout en permettant une révision humaine si nécessaire.
Datacapt AI facilite la conception de l’eCRF en suggérant des structures de formulaires, des champs, des contrôles de cohérence (edit checks) et des règles de validation basés sur le contenu du protocole et le contexte thérapeutique. Cela permet de réduire le temps de paramétrage de l'étude tout en améliorant la cohérence globale.
Non. Datacapt AI ne génère ni n'altère les données cliniques. Elle analyse les données et les flux de travail existants pour fournir des suggestions, des alertes et des analyses. La saisie des données, les modifications et les approbations restent sous le contrôle exclusif de l'utilisateur et sont consignées dans l'audit trail, conformément aux réglementations cliniques.
Datacapt AI est conçu spécifiquement pour les essais cliniques et est directement intégré à l'environnement Datacapt. Contrairement aux outils d'IA généralistes, il est bâti autour des flux de travail cliniques, des contraintes réglementaires et des impératifs d'intégrité des données. Cela garantit une valeur opérationnelle réelle sans compromis sur la conformité ou le contrôle.
Le Model Context Protocol est un standard ouvert qui décrit comment un grand modèle de langage découvre et appelle les fonctions d'une application tierce. Le serveur MCP de Datacapt publie les capacités de l'EDC comme des outils qu'un agent peut appeler : un data manager formule sa demande en langage clair au lieu d'attendre qu'un connecteur soit développé pour elle. L'API REST fait toujours le travail en dessous. MCP ajoute la couche qui permet à un modèle de l'utiliser sans qu'un développeur écrive une intégration pour chaque scénario.
Oui. Vous pouvez piloter Datacapt depuis le chat intégré à la plateforme, ou depuis le client MCP de votre choix connecté au modèle que votre organisation a validé : Claude, ChatGPT, Gemini, Grok ou un modèle que vous hébergez localement. Le protocole ne dépend pas du modèle. Les deux voies passent par le même serveur MCP, avec les mêmes scopes et la même piste d'audit : un modèle local n'obtient pas plus d'accès que celui intégré.
Non. Le modèle reçoit des volumes, des statuts, des pourcentages et des structures : les inclusions par centre, le taux de SDV, la répartition des queries par ancienneté, les sections d'un formulaire avec leurs règles de validation. Il ne reçoit jamais une valeur saisie dans un eCRF, une réponse ePRO, un identifiant sujet ou de screening, le contenu d'un consentement ni un élément de randomisation. Les endpoints de monitoring qui renvoient des lignes au niveau des inclusions sont d'abord agrégés par le serveur : une ligne brute ne quitte jamais la plateforme. Seule exception, un terme verbatim envoyé seul pour une suggestion de codage, sans sujet, centre, date ni visite.
Non. Les écritures sont confinées aux études en DRAFT ou à une nouvelle version d'étude, et ce contrôle est dans le backend plutôt que dans les instructions données au modèle. Modifier un formulaire publié, appliquer un code ou écrire sur des données collectées n'est pas exposé comme outil. Le passage en production demande l'acceptation explicite d'un utilisateur, enregistrée dans la piste d'audit à son nom. Une fois l'étude en LIVE, tout changement passe par une nouvelle version, qui repart en brouillon, et l'agent avec elle.
Blog & News Datacapt
Les derniers articles, guide et tutoriels.